1. Long read based Genome Assembly
Methods
Code
bash
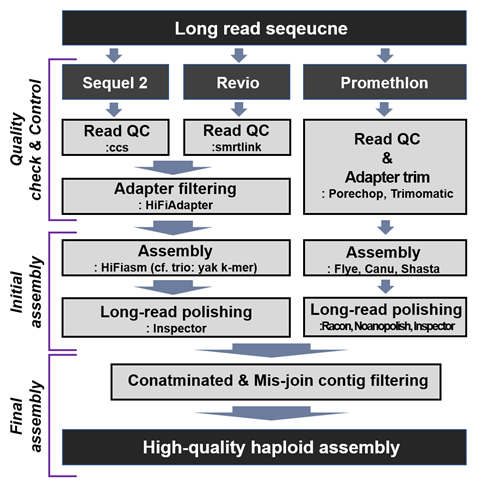
# 1.Read QC (Long-Read Data Quality Control)
ccs input.bam output.ccs.bam
porechop -i KPR_ont_reads.fastq -o KPR_ont_trimmed.fastq


# 2.Adapter filtering/trim
hifiadapterfilt --in KPR_input.ccs.fastq --out KPR_filtered.fastq


# 3.Initial assembly
hifiasm \
    -o KPR.asm \
    --dual-scaf \
    --telo-m CCCTAA \
    --h1 KPR_read1.fq.gz \
    --h2 KPR_read2.fq.gz \
    --ul KPR_ul.fq.gz \
    KPR-HiFi.fq.gz

flye \
    --nano-raw KPR_ont_trimmed.fastq \
    --out-dir KPR_flye_out \
    --genome-size 3g \
    --threads 32

canu \
    -p asm \
    -d KPR_canu_out \
    genomeSize=3g \
    -nanopore-raw KPR_ont_trimmed.fastq \
    useGrid=false \
    maxThreads=32

shasta \
    --input KPR_ont_trimmed.fastq \
    --assemblyDirectory shasta_out \
    --threads 32


# 4.Long-read polishing
racon KPR_ont_reads.fastq KPR_ont_aln.sam flye_out/KPR_assembly.fasta > racon_KPR_polished.fasta
nanopolish variants --consensus polished.fa \
    --reads KPR_ont_trimmed.fastq \
    --bam KPR_aln.sorted.bam \
    --genome flye_out/assembly.fasta \
    --threads 32
inspector -i KPR_output.asm.p_ctg.fa -b KPR_aln.bam -o KPR_inspector_out


# 5.Contaminated & mis-join contig filtering
# 5-1) Contamination detection
blobtools create --fasta KPR_assembly.fasta --bam KPR_aln.sorted.bam --taxid-mapping taxdump
kraken2 --db kraken_db --threads 32 --output KPR_kraken.out --report KPR_kraken.report assembly.fasta

# 5-2) Mis-join contig detection
quast.py KPR_assembly.fasta -r reference.fa -o quast_out
tigmint-make tigmint draft=assembly reads=KPR_ont_trimmed.fastq
juicer.sh -d juicer_out -D /path/to/juicer_tools -z KPR_assembly.fasta -p chrom.sizes -s MboI
run-asm-pipeline.sh KPR_assembly.fasta juicer_out/aligned/KPR_merged_nodups.txt


# 6.Construction of the Pangenome
# 6-1) Preparing the Input Seqfile
KOR-101.1   paternal.fa
KOR-101.2   maternal.fa
CHM13.0   chm13.fa
GRCh38    grch38.fa

# 6-2) Fixing problem contigs
wget -q $(grep KOR-102\.1 KPR-mc.seqfile | tail -1 | awk '{print $2}') -O KOR-102.1.fa.gz
gzip -d KOR-102.1.fa.gz
samtools faidx KOR-102.1.fa

# 6-3) Adding the Y-chromosome to the CHM13 reference used together
wget -q $(grep CHM13 KPR-mc.seqfile | tail -1 | awk '{print $2}') -O CHM13.Y.v1.1.fa.gz
wget -q $(grep GRCh38 KPR-mc.seqfile | tail -1 | awk '{print $2}') -O GRCh38.fa.gz
gzip -d GRCh38.fa.gz

samtools faidx GRCh38.fa chrY chrEBV | bgzip --threads 8 >> CHM13.Y.KPR.fa.gz
aws s3 cp CHM13.Y.KPR.fa.gz ${MYBUCKET}/fasta/

grep -v CHM13 KPR-mc.seqfile > t
printf "CHM13_1_1\t${MYBUCKET}/fasta/CHM13.Y.KPR.fa.gz\n" > KPR-mc.seqfile
cat t >> KPR-mc.seqfile

# 6-4) Standardizing Contig Naming Rules
cactus-preprocess ${MYJOBSTORE} KPR-mc.seqfile KPR-mc.pp.seqfile \
    --configFile ./config_cut_hash.xml --realTimeLogging \
    --batchSystem mesos --provisioner aws --defaultPreemptable \
    --nodeType r5.8xlarge --nodeStorage 500 --maxNodes 2 \
    --skipMasking --logFile KPR-mc-grch38.pp.log

# 6-5) Construction of Pangenome
cactus-minigraph "${MYJOBSTORE}" KPR-mc.pp.seqfile \
    "${MYBUCKET}/KPR-minigraph-grch38.gfa.gz" \
    --reference GRCh38 \
    --realTimeLogging \
    --batchSystem mesos --provisioner aws --defaultPreemptable \
    --nodeType r5.8xlarge:1.5 --nodeStorage 650 --maxNodes 25 \
    --betaInertia 0 --targetTime 1 \
    --logFile KPR-minigraph-grch38.log
2. Securing Genetic Variation Data Based on Long-Read Sequencing
Simplified Pipeline
Code
bash
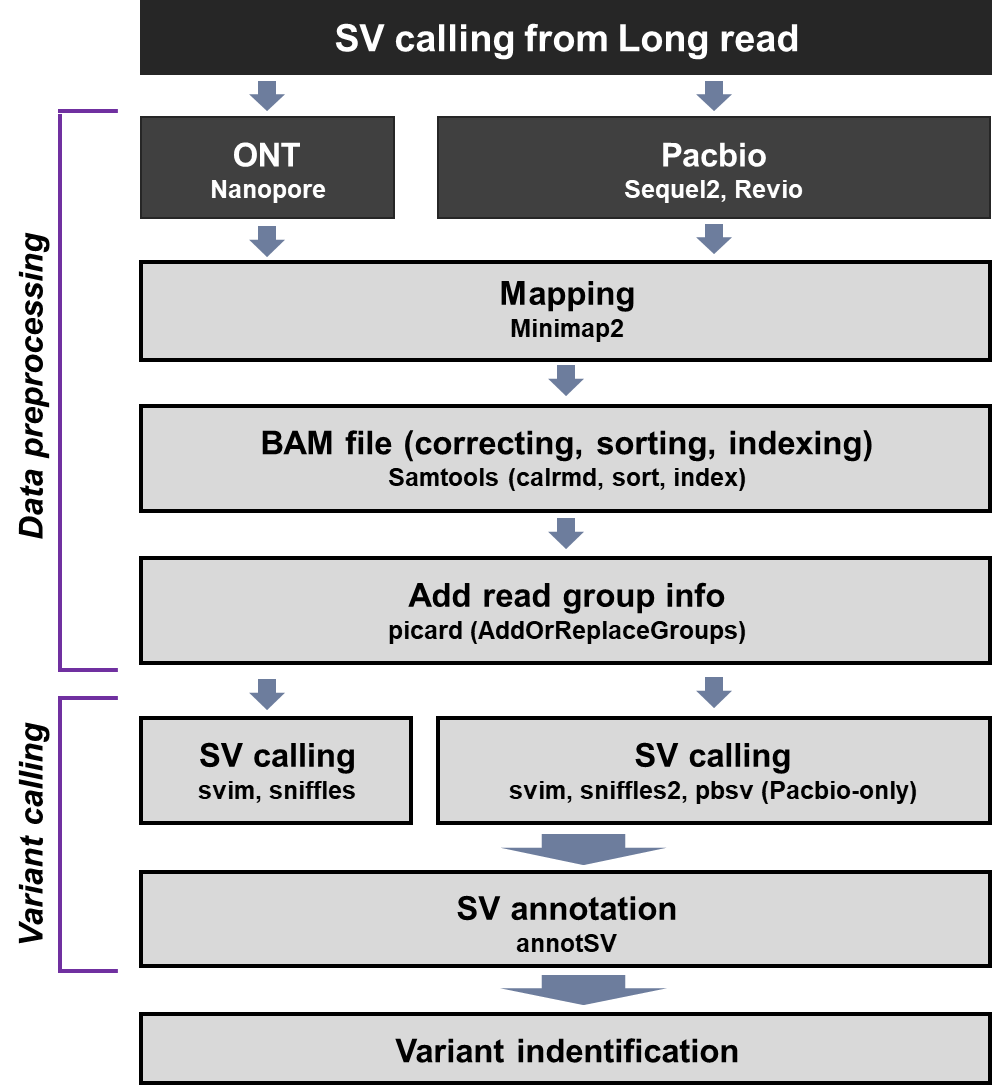
# 1.Read QC (Quality Control of Long-Read Sequences)
fastqc sample.fastq.gz -o platform_qc


# 2.Alignment of ONT Ultra-Long-Reads
minimap2 -ax map-ont reference.fa KPR_ont_reads.fastq > KPR_ont_aln.sam


# 3.Alignment of PacBio HiFi Reads
minimap2 -ax map-pb reference.fa KPR_pb_reads.fastq > KPR_pb_aln.sam


# 4.SAM → BAM Conversion and Sorting
samtools view -bS KPR_aln.sam | samtools sort -o KPR_aln.sorted.bam


# 5.CIGAR / MD Tag Correction
samtools calmd -b KPR_aln.sorted.bam reference.fa > KPR_aln.calmd.bam


# 6.BAM file indexing
samtools index KPR_aln.calmd.bam


# 7.Adding Read Group Information to the BAM Header
picard AddOrRxeplaceReadGroups
    I=KPR_aln.calmd.bam
    O=KPR_aln.rg.bam
    RGID=sample
    RGLB=lib1
    RGPL=ONT
    RGSM=sample_name


# 8.Sniffles2 SV calling (ultra-long-read)
sniffles --input KPR_aln.rg.bam —vcf KPR_sniffles.vcf


# 9.SVIM SV calling (ultra-long-read)
svim alignment KPR_svim_out_dir reference.fa KPR_aln.rg.bam


# 10.pbsv (PacBio-specific SV) calling
pbsv discover KPR_aln.rg.bam KPR_sample.svsig.gz
pbsv call reference.fa KPR_sample.svsig.gz KPR_pbsv.vcf


# 11.VCF File Merging
SURVIVOR merge KPR_file_list.txt 100 1 1 0 0 50 KPR_merged.vcf


# 12.SV annotation
AnnotSV -SVinputFile KPR_merged.vcf -genomeBuild GRCh38 -outputFile KPR_annotated.tsv
3. Long-Read Based Transcriptome and Isoform Expression Analysis
Method
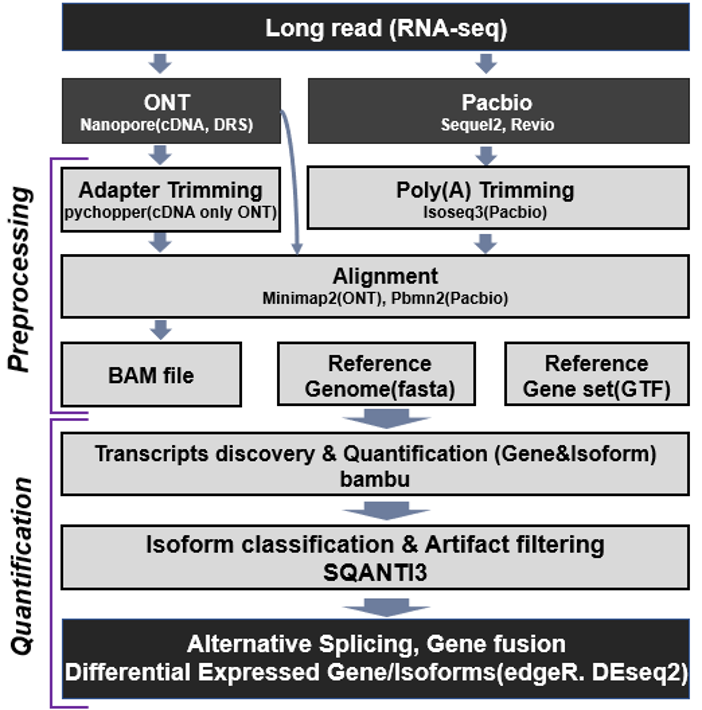
Code
bash
# 1.Data Processing
pychopper -i input.fq \
    -o output.fq \
    -k cDNA_SSP_VNP.fas \
    -r chopper_report.pdf \
    -u unusable.fq

lima ccs.bam isoseq_primers.fasta flnc.bam | \
    isoseq3 refine --require-polya output.bam \
    isoseq_primers.fasta flnc.bam


# 2.Alignment
# 2-1) ONT
minimap2 -d ref.mmi ref.fa | \
minimap2 -ax splice -uf -k14 \
  --secondary=no -Y -t 24 ref.mmi input.fq | \
samtools sort -o output.sorted.bam

# 2-2) PacBio
pbmm2 index ref.fa ref.mmi | \
pbmm2 align ref.mmi input.bam output.bam \
  --preset ISOSEQ --sort


# 3.Transcript discovery & Quantification
bambuAnnotations <- prepareAnnotations(ref.gtf)
se <- bambu(
  reads = input.bam,
  annotations = bambuAnnotations,
  genome = ref.fa
)
writeBambuOutput(se, path)


# 4.Isoform classification & Artifact filtering
# 4-1) QC (Quality Control)
sqanti3_qc.py --isoforms bambu_results.gtf \
    --refFasta ref.fa \
    --refGTF ref.gtf \
    -d directory \
    -o output_prefix

# 4-2) Filtering
sqanti3_filter.py rules \
    --quanti_class classification.txt \
    --filter_isoforms corrected.fasta \
    --filter_gtf corrected.gtf \
    -e \
    -o output_prefix \
    -d directory
4. Pangenome-based Variant Extraction
Method
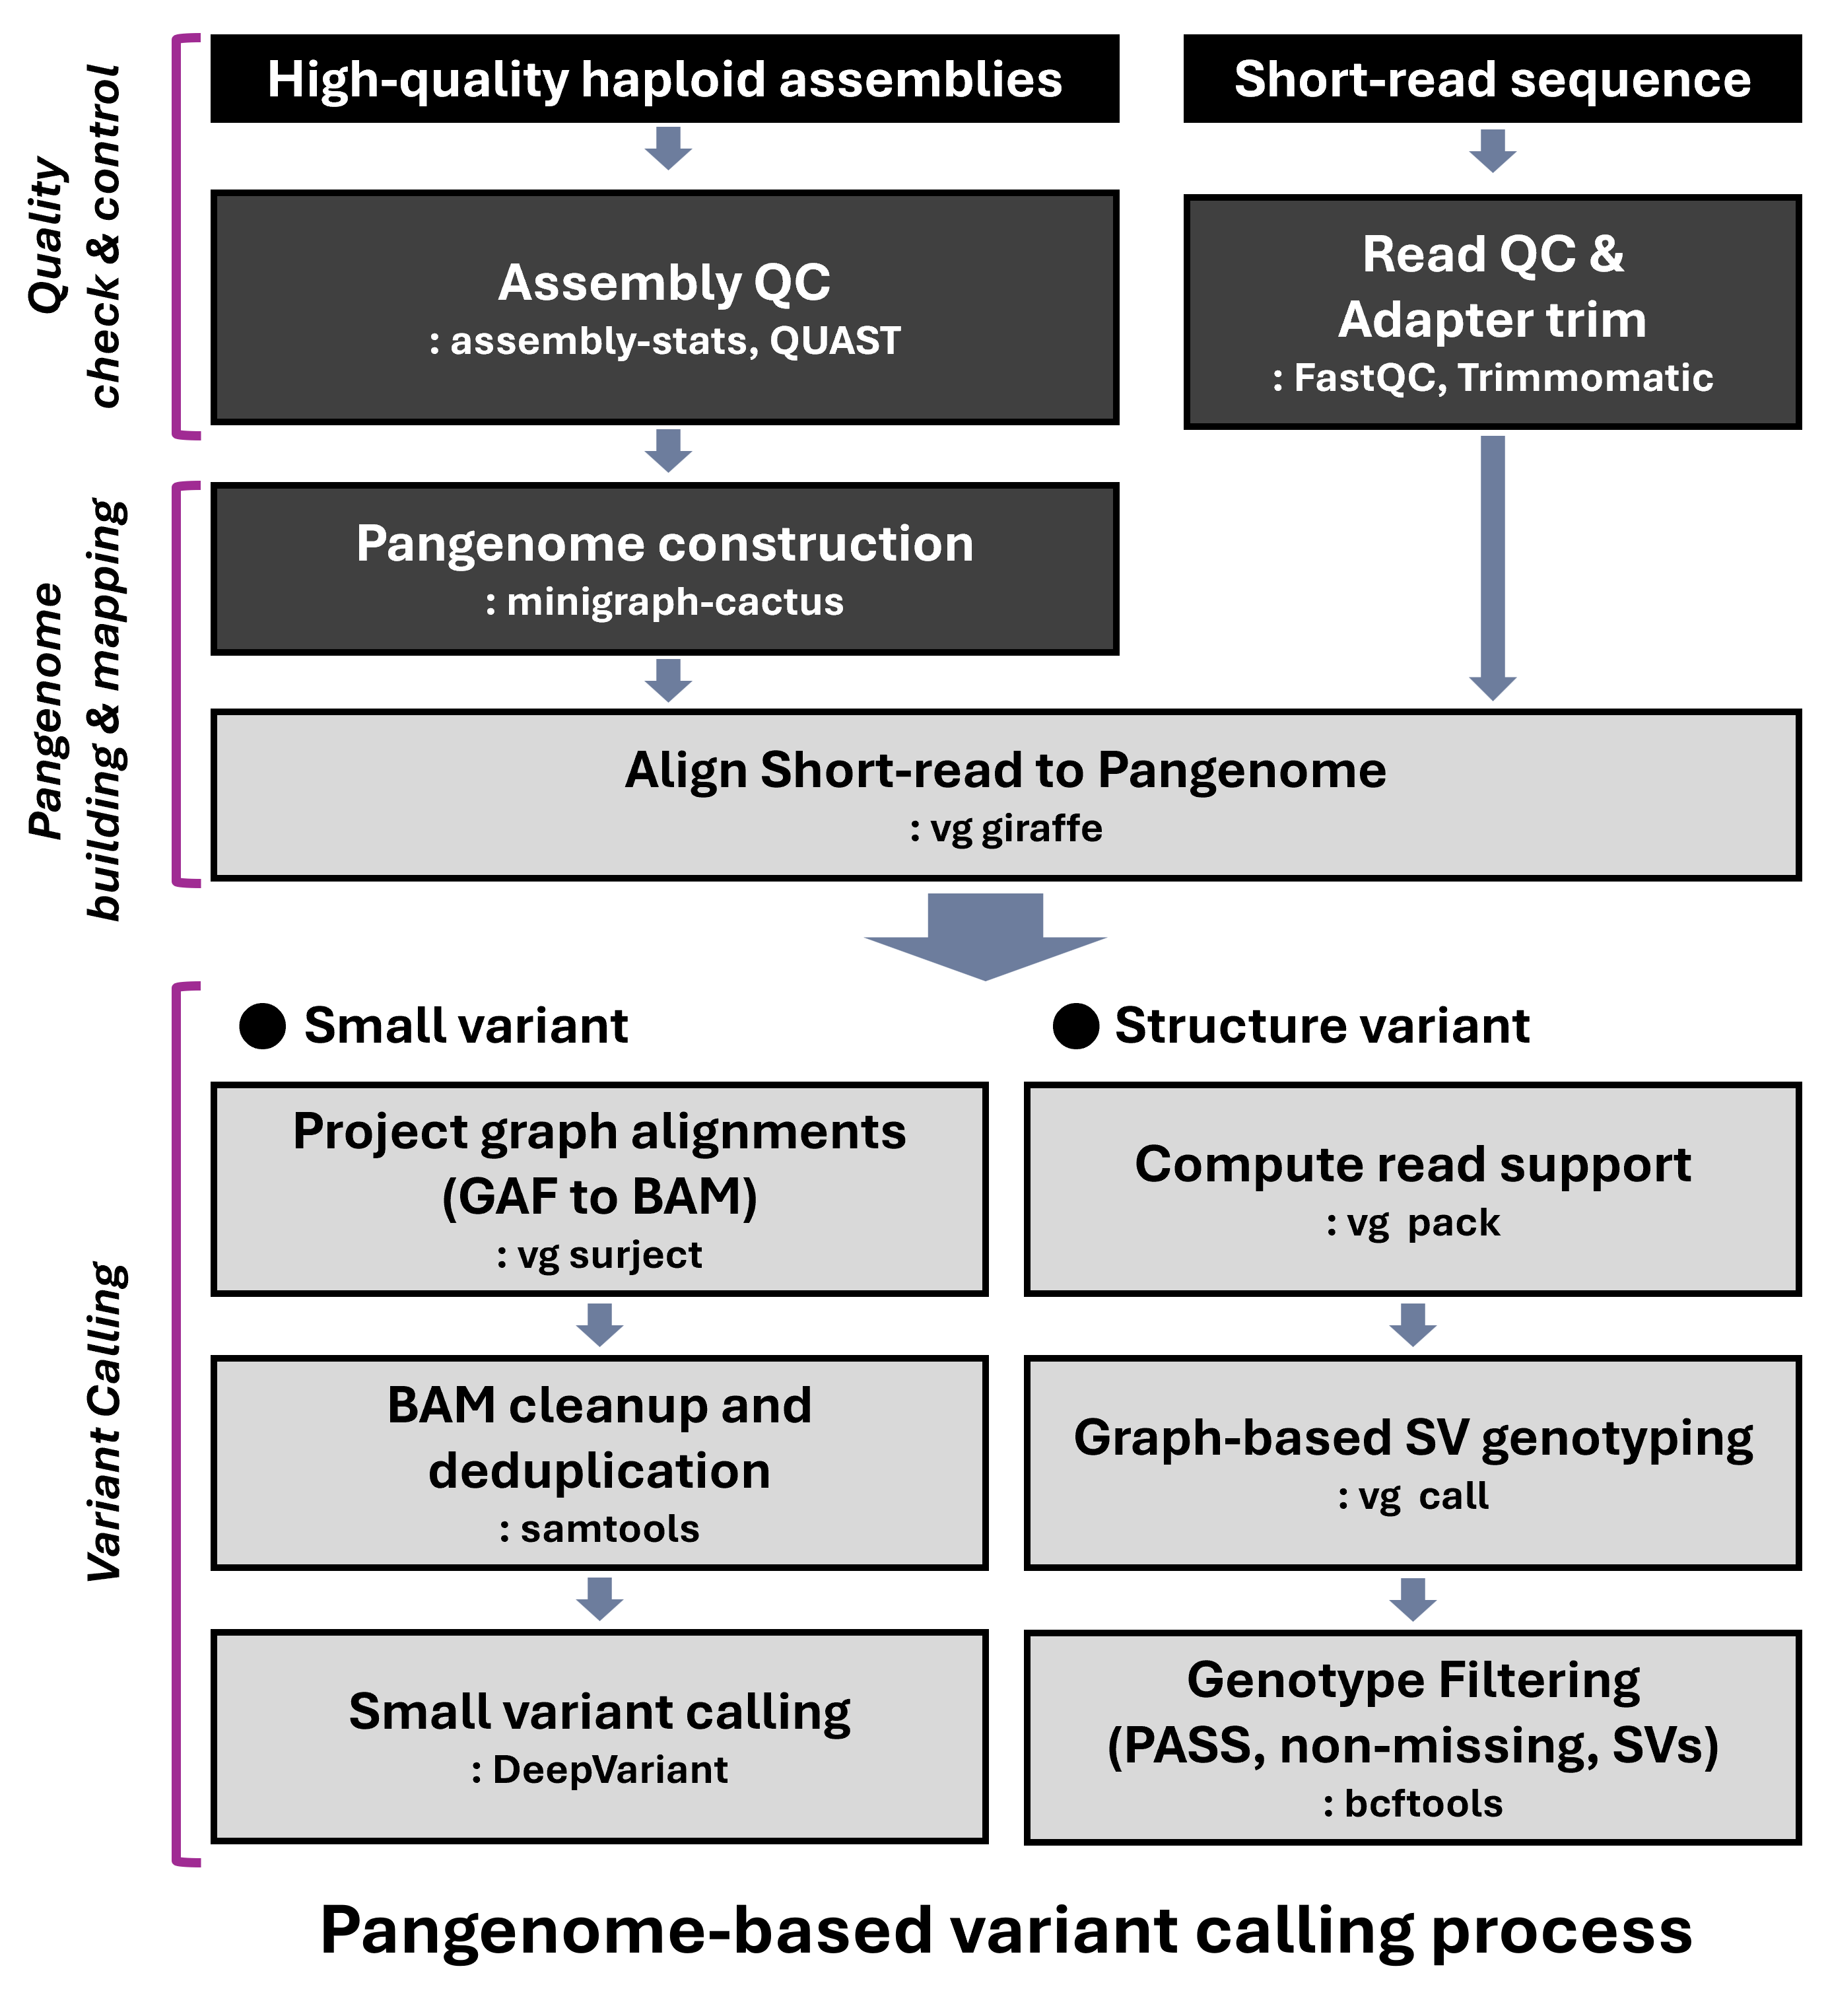
Code
bash
# 1.Assembly QC(Quality assessment script for high-quality genome assemblies)
# Assembly-stats
assembly-stats ${sample}.fasta > ${sample}.assembly.stats

# QUAST
quast.py \
${sample}.h1.fasta ${sample}.h2.fasta \
-o ${sample}.quast.out


# 2.Short-read data quality assessment and trimming (FastQC, Trimmomatic)
# FastQC
fastqc -o ${output_path} *.fastq.gz

# Trimmomatic
java -jar trimmomatic-0.39.jar PE \
${sample}.R1.fastq.gz ${sample}.R2.fastq.gz \
${sample}.paired.R1.fastq.gz ${sample}.unpaired.R1.fastq.gz \
${sample}.paired.R2.fastq.gz ${sample}.unpaired.R2.fastq.gz \
ILLUMINACLIP:TruSeq3-PE.fa:2:30:10:2:True LEADING:3 TRAILING:3 MINLEN:36


# 3.Graphical Pangenome construction
# 3-1) Example of cactus-pangenome input sequenceFile.tsv
GRCh38 GRCh38.fasta
sample1.1 sample1.h1.fasta
sample1.2 sample1.h2.fasta
sample2.1 sample2.h1.fasta
sample2.2 sample2.h2.fasta
sample3.1 sample3.h1.fasta
sample3.2 sample3.h2.fasta

# 3-2) Pangenome construction (cactus-pangenome)
cactus-pangenome ./jobstorepath ./sequenceFile.tsv \
--outName ${graph} --outDir ${graph} \
--reference GRCh38  \
--filter ${N} \
--vcf --viz --odgi \
--chrom-vg clip filter --chrom-og clip filter \
--giraffe clip filter \
--gbz clip filter full \
--gfa clip full


# 4.Align short-reads to pangenome
# 4-1) Short-read k-mer frequency data generation (kmc) script
kmc -k29 -m128 -okff -t16 -hp \
-fq @sample.lst \
${sample} \
${TMPDIR}

# 4-2) vg giraffe
vg giraffe \
-Z ${graph}.gbz \
-f ${sample}.R1.fastq.gz -f ${sample}.R2.fastq.gz \
-o gaf \
--sample ${sample} \
--progress \
--kff-name ${prefix}.kff \
--haplotype-name ${reference}.hapl \
| bgzip -c > ${sample}.${graph}.gaf.gz


# 5.Small Variant Detection
# 5-1) Extracting a Specific Graph Path from the Pangenome (e.g., GRCh38)
# Path file generation
vg paths \
--sample GRCh38 \
-L \
-x ${graph}.gbz > GRCh38.${graph}.paths.txt

# Fasta file generation
vg paths \
--sample GRCh38 \
--extract-fasta \
-x ${graph}.gbz > GRCh38.${graph}.fasta

# Fasta index generation
samtools faidx GRCh38.${graph}.fasta


# 5-2) Project graph alignments
vg surject \
-x ${graph}.gbz \
-G ${sample}.${graph}.gaf.gz \
-F GRCh38.${graph}.paths.txt \
-b \
-N ${sample} \
-R "ID:${sample} LB:lib1 SM:${sample} PL:illumina PU:unit1" \
> ${sample}.GRCh38.bam

# 5-3) BAM cleanup and deduplication
# Step01~03
samtools reheader $DICT ${sample}.GRCh38.bam \
  | samtools addreplacerg -r "@RG\tID:${sample}\tSM:${sample}\tPU:unit1" - \
  | samtools sort -@ 8 -O BAM -T TMP/${sample}.tmp \
      -o ${sample}.GRCh38.sort.bam.temp

# Step04
samtools rmdup \
  ${sample}.GRCh38.sort.bam.temp \
  ${sample}.GRCh38.sort.rmdup.bam

# Step05
samtools index -@ 2 \
  ${sample}.GRCh38.sort.rmdup.bam

# Remove temporary files
rm -f ${sample}.GRCh38.sort.bam.temp

# 5-4) DeepVariant
docker run --rm --gpus all \
  --workdir ${workdir} \
  nvcr.io/nvidia/clara/clara-parabricks:4.4.0-1 \
  pbrun deepvariant \
  --ref GRCh38.${graph}.fasta \
  --in-bam /workdir/${i} \
  --out-variants ${sample}.GRCh38.dp.vcf.gz \
  --gvcf \
  --sort-by-haplotypes \
  --parse-sam-aux-fields \
  --mode shortread


# 6.Structure variant calling
# 6-1) Compute read support from GAM
vg pack \
  -x ${graph}.gbz \
  -Q 5 \
  -a ${sample}.gaf.gz \
  -o ${sample}.gaf.pack

# 6-2) Graph-based SV genotyping
vg call \
  ${sample}.gbz \
  -r ${sample}.snarls \
  -k ${sample}.gaf.pack \
  -s ${sample} \
  -S GRCh38 \
  -a \
| bgzip > ${sample}.gaf.sv.vcf.gz

# 6-3) Genotype Filtering
# VCF index file generation
bcftools index -f ${sample}.gaf.sv.vcf.gz

# Parse variants with FILTER="PASS"
bcftools view \
  -i 'FILTER="PASS"' \
  ${sample}.gaf.sv.vcf.gz \
  -Oz -o temp_${sample}.vcf.gz

# Reorder the VCF header information based on the .fai file
bcftools reheader \
  --fai GRCh38.${graph}.fasta.fai \
  -o ${sample}.gaf.sv.PASS.vcf.gz \
  temp_${sample}.vcf.gz
tabix -p vcf ${sample}.gaf.sv.PASS.vcf.gz

# Remove variants with GT="0/0"
bcftools view \
  -e 'GT="0/0"' \
  ${sample}.gaf.sv.PASS.vcf.gz \
  -Oz -o ${sample}.gaf.sv.PASS.NoZero.vcf.gz
tabix -p vcf ${sample}.gaf.sv.PASS.NoZero.vcf.gz

#Remove variants with GT="0/0" or GT="./."
bcftools view \
  -e 'GT="0/0" | GT="./."' \
  ${sample}.gaf.sv.PASS.NoZero.vcf.gz \
  -Oz -o ${sample}.gaf.sv.PASS.NoZeroNoMiss.vcf.gz
tabix -p vcf ${sample}.gaf.sv.PASS.NoZeroNoMiss.vcf.gz